3위안·2시간, 64M LLM을 직접 만든다 MiniMind
LLM이 만들어지는 전 과정을 직접 따라가 보고 싶다면?
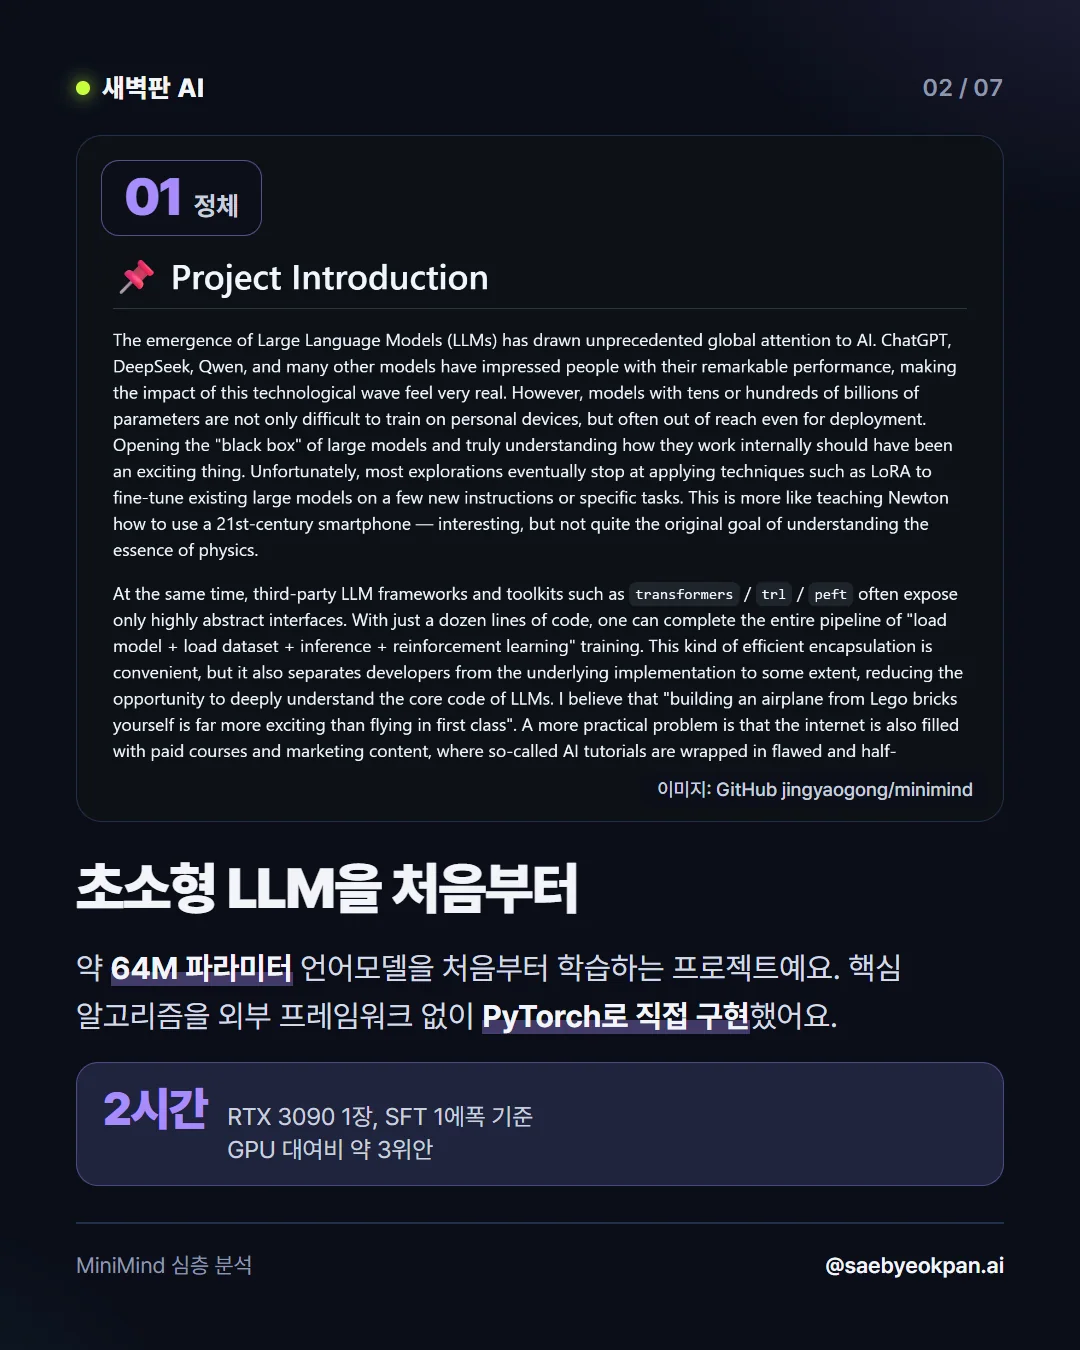
01정체
초소형 LLM을 처음부터
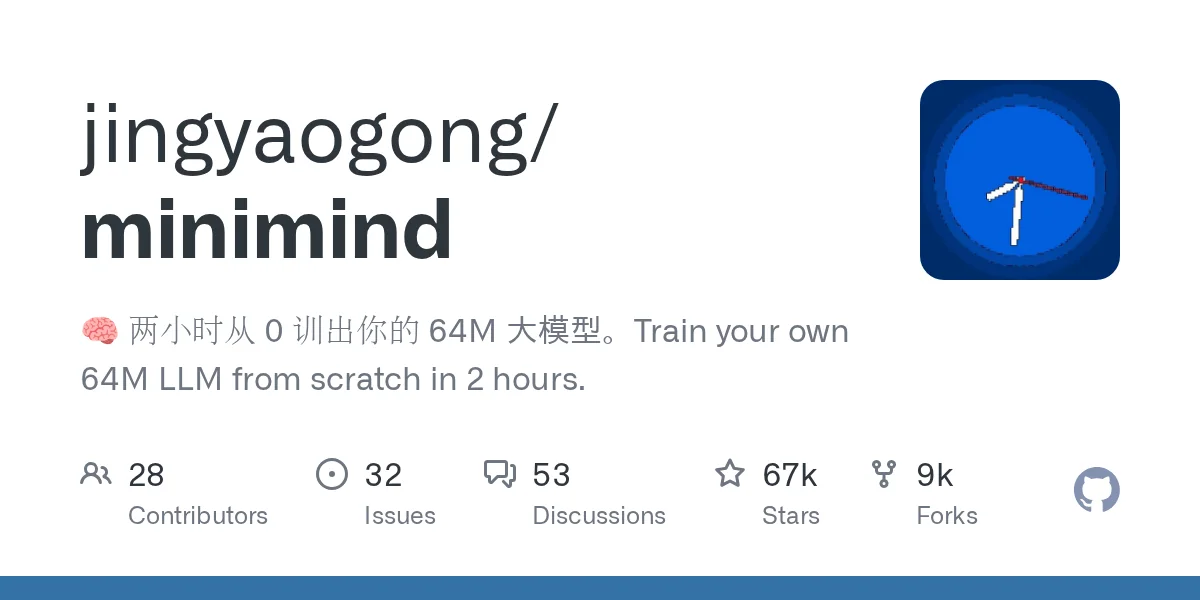
약 64M 파라미터 언어모델을 처음부터 학습하는 프로젝트예요. 핵심 알고리즘을 외부 프레임워크 없이 PyTorch로 직접 구현했어요.
2시간RTX 3090 1장, SFT 1에폭 기준
GPU 대여비 약 3위안
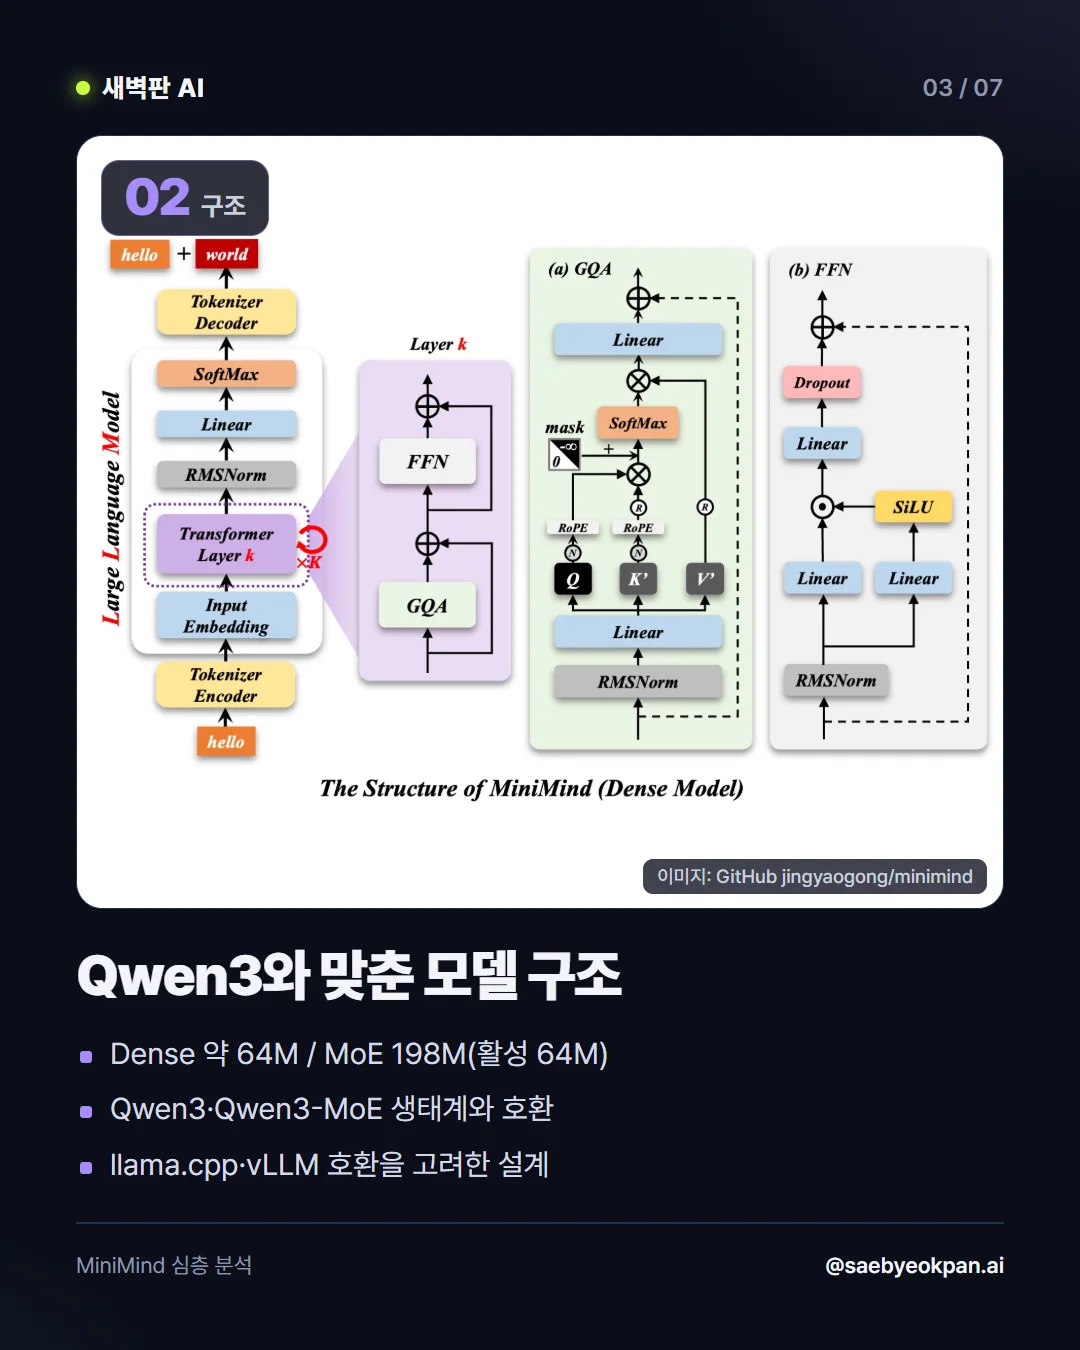
02구조
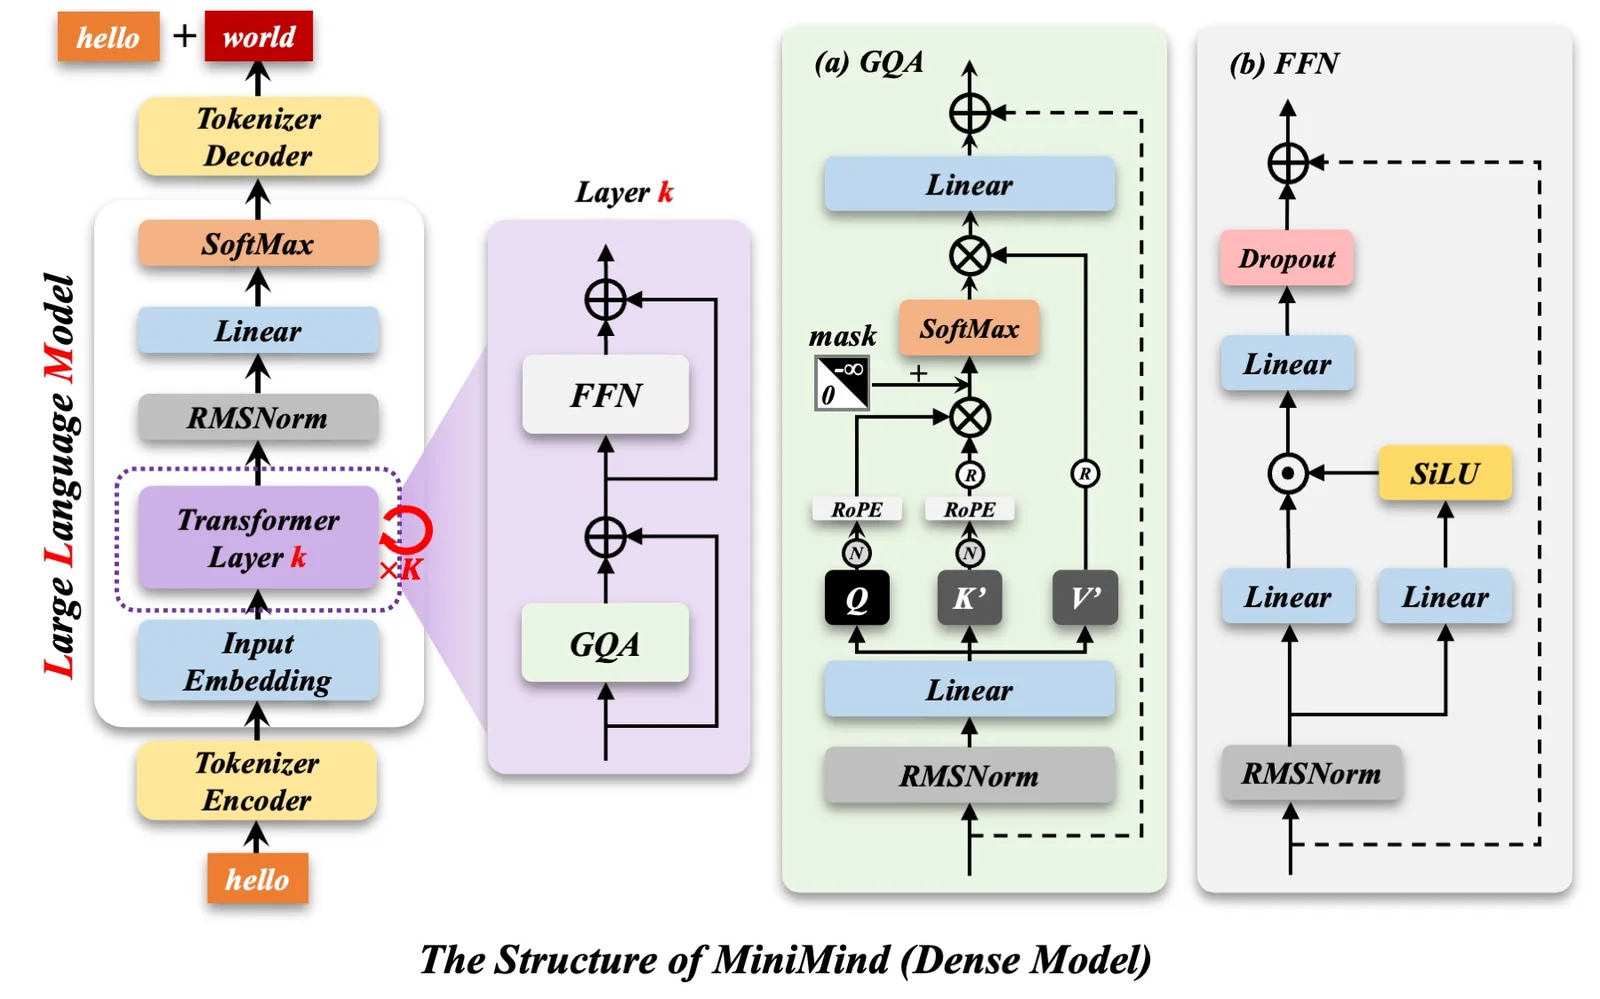
Qwen3와 맞춘 모델 구조
- Dense 약 64M / MoE 198M(활성 64M)
- Qwen3·Qwen3-MoE 생태계와 호환
- llama.cpp·vLLM 호환을 고려한 설계
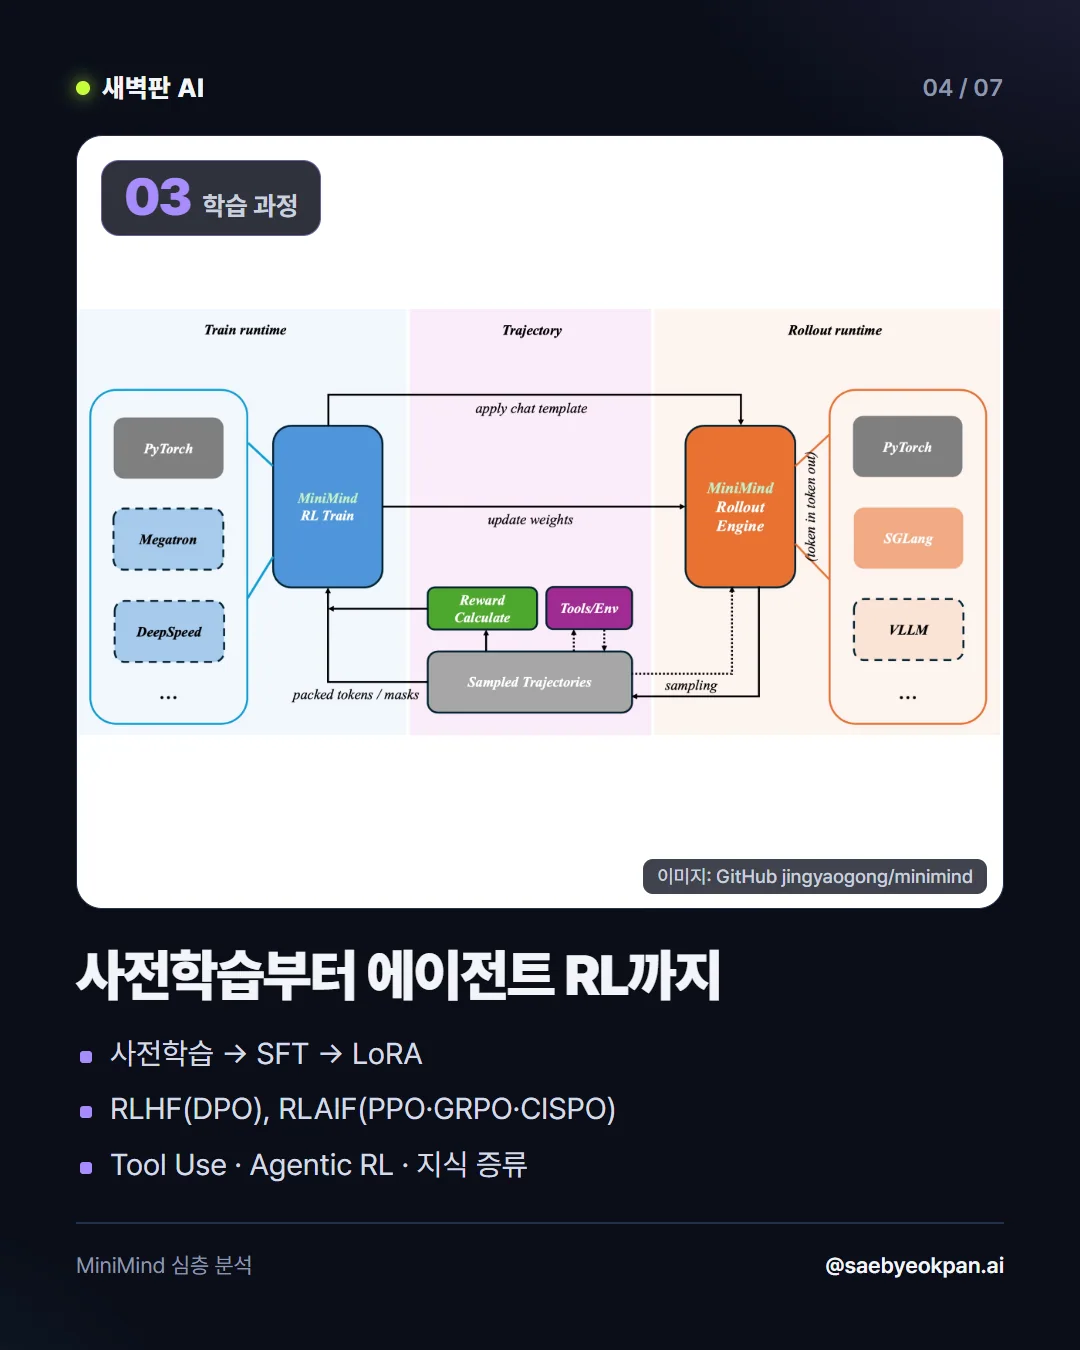
03학습 과정
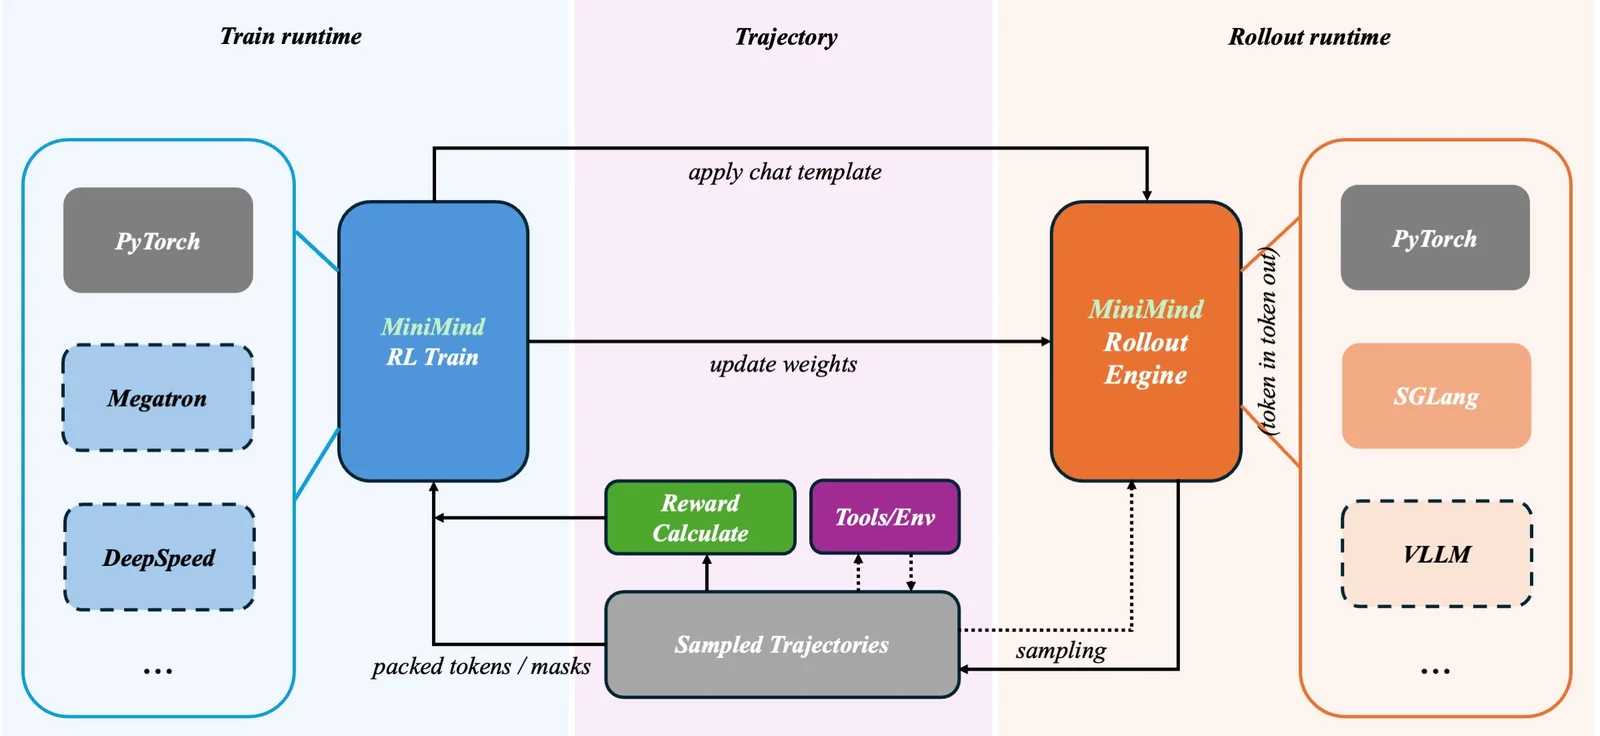
사전학습부터 에이전트 RL까지
- 사전학습 → SFT → LoRA
- RLHF(DPO), RLAIF(PPO·GRPO·CISPO)
- Tool Use · Agentic RL · 지식 증류
04결과물
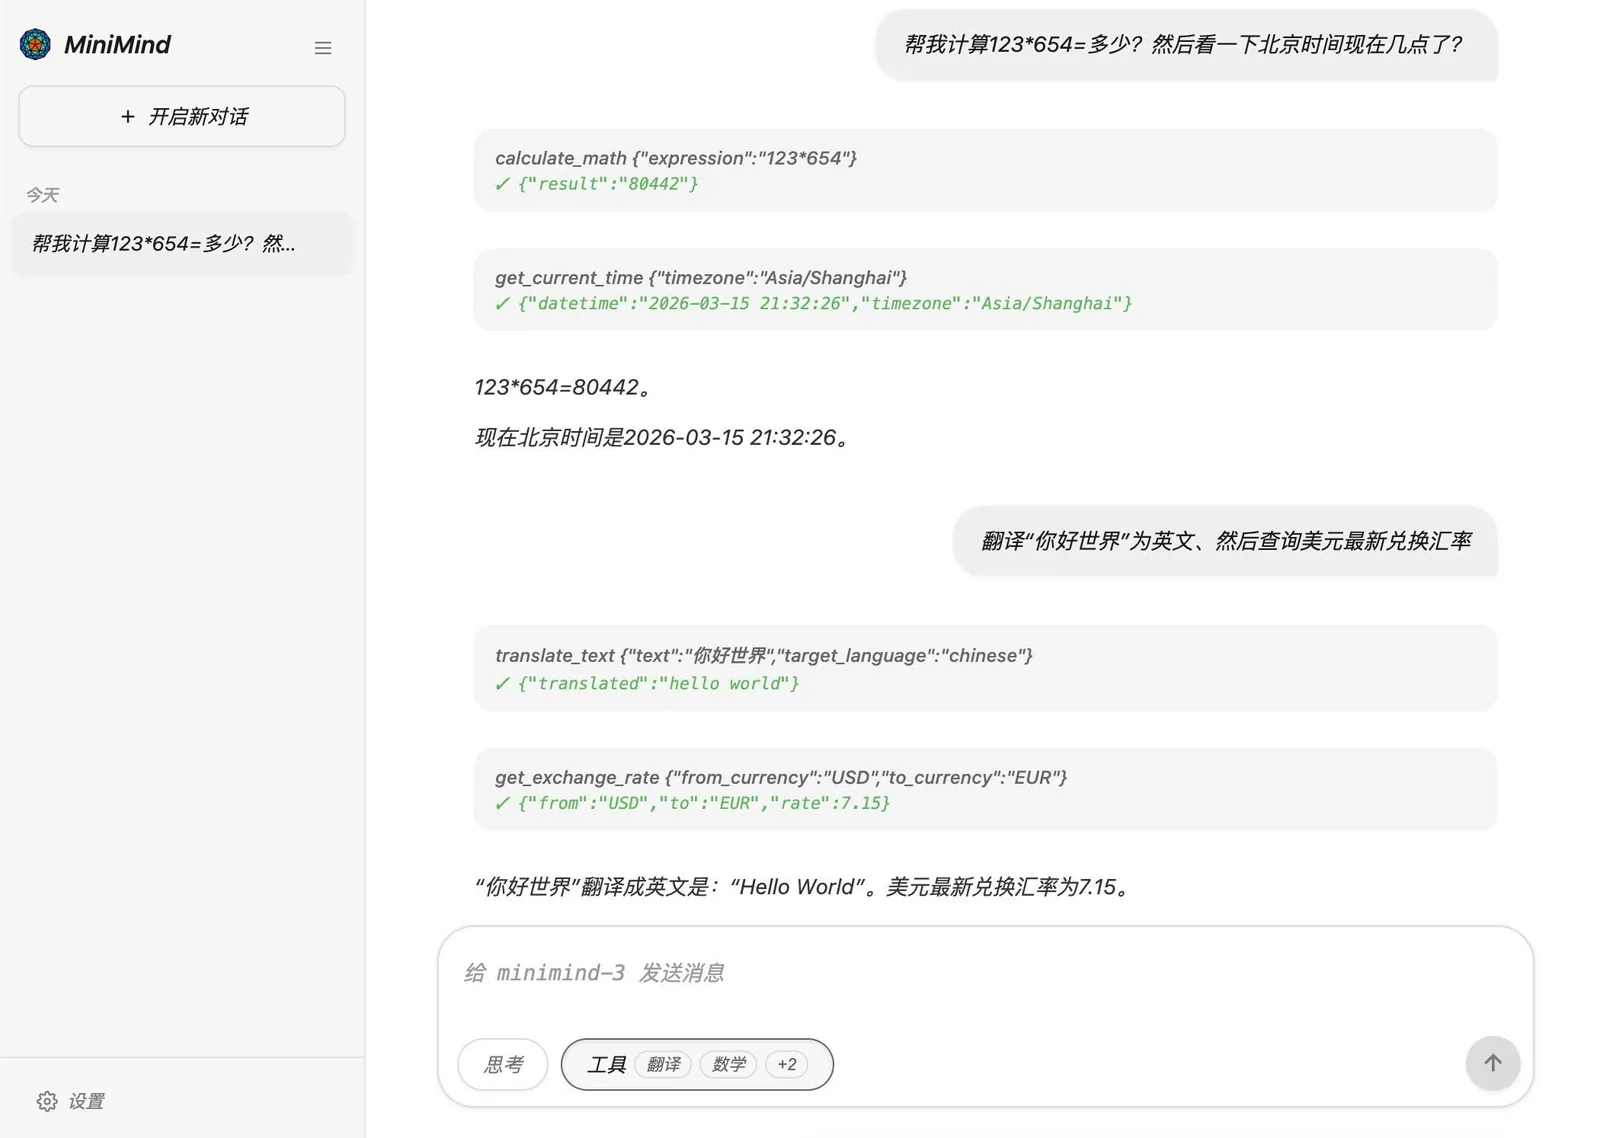
도구 호출까지 하는 작은 모델
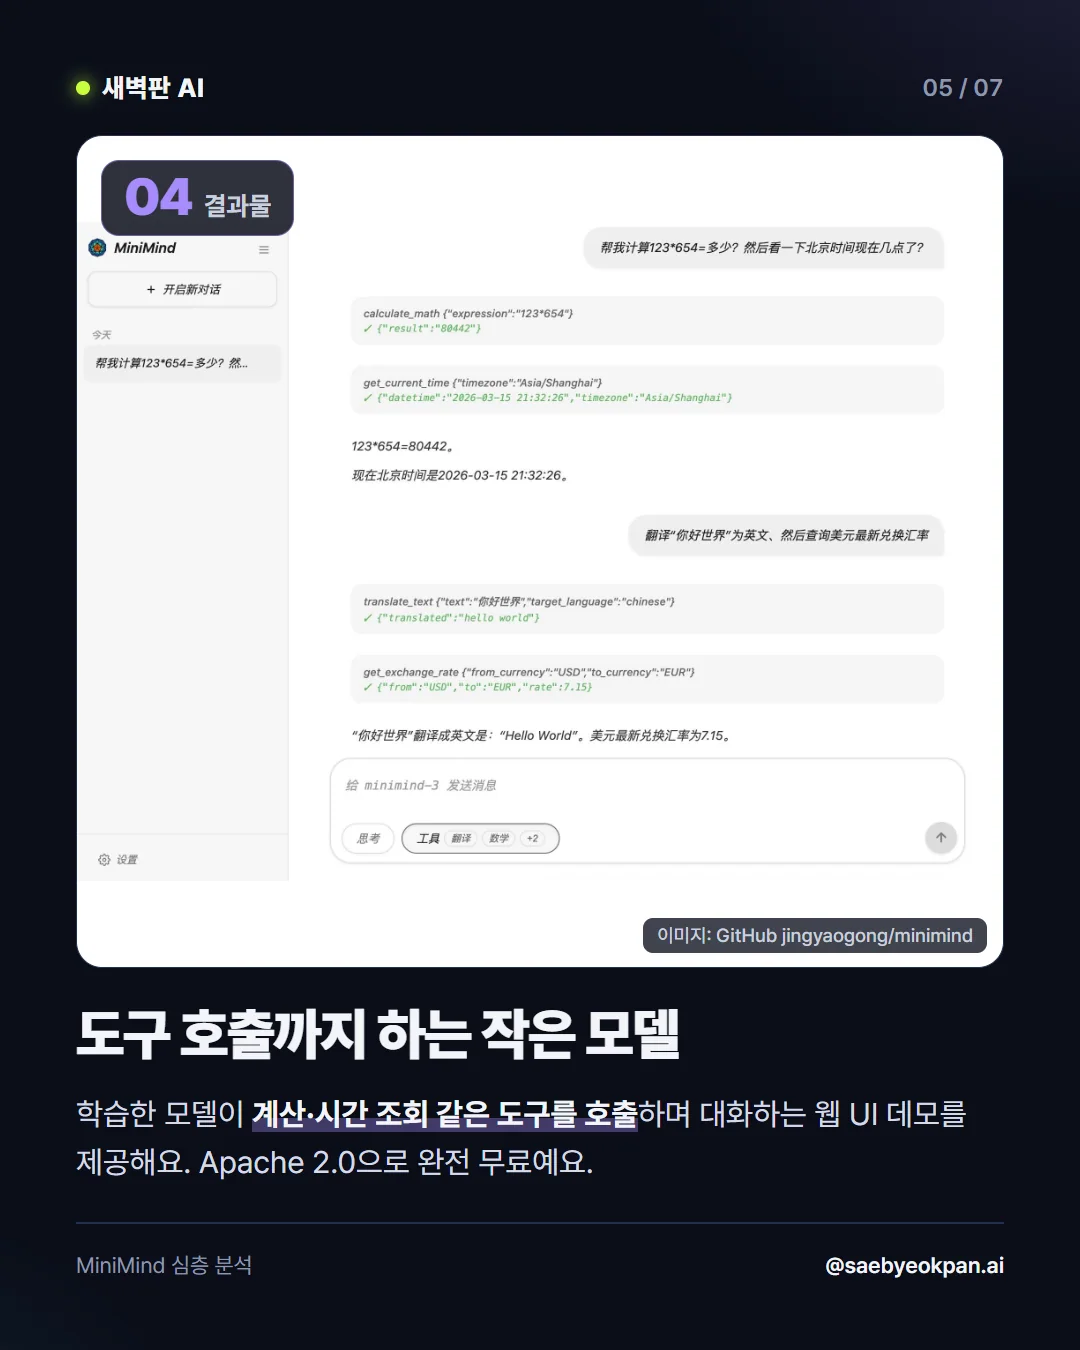
학습한 모델이 계산·시간 조회 같은 도구를 호출하며 대화하는 웹 UI 데모를 제공해요. Apache 2.0으로 완전 무료예요.
한눈에 정리
- 64M 초소형 LLM을 처음부터 학습하는 교육용 프로젝트
- RTX 3090 1장·약 2시간·약 3위안이면 SFT 재현
- 사전학습~에이전트 RL까지 전 과정을 직접 구현
출처 · GitHub jingyaogong/minimind — 원문 보기
카드뉴스로 보기